 Артём Ротганк
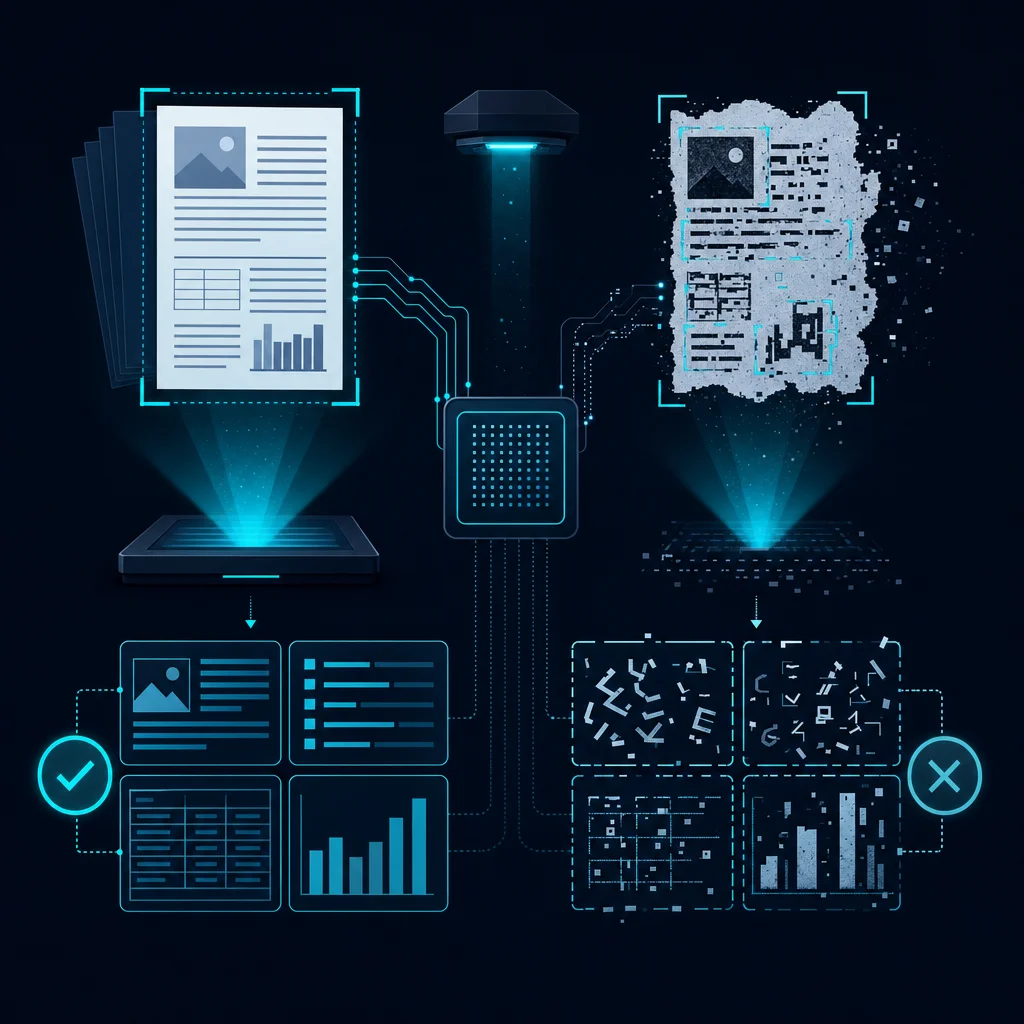
TL;DR: OCR в 2026 — это не одна технология, а карта инструментов: классические движки для чистого печатного текста, нейросетевые детекторы и распознаватели для «грязных» изображений, специализированные модели для таблиц и формул, облачные API для качества из коробки и мультимодальные LLM — когда нужен не текст, а смысл. Главная ошибка — брать один инструмент на все задачи. Ниже разбираю, где у каждого граница применимости.
Карта инструментов: кто за что отвечает
Прежде чем выбирать, важно понимать, что «OCR» — это конвейер из нескольких этапов: детекция текстовых областей, распознавание символов, а для документов — ещё и понимание структуры (абзацы, таблицы, формы). Разные инструменты закрывают разные этапы, поэтому сравнивать их «в лоб» бессмысленно.
Классические и нейросетевые движки общего назначения
Tesseract 5.x — эталонная отправная точка. Пятая версия использует LSTM вместо старого символьного классификатора, что заметно подняло качество по сравнению с эпохой Tesseract 3-4. Чистый печатный текст на хорошем скане он читает почти без ошибок, включая русский. Границы: рукопись прочитает плохо, сложную многоколоночную вёрстку — с перепутанным порядком чтения, текст на фото с телефона — только после серьёзной предобработки.
EasyOCR — нейросетевой движок (детекция CRAFT + распознавание CRNN) с поддержкой 80+ языков, включая русский. Лучше Tesseract на «грязных» изображениях: снимки экрана, вывески, фото документов. За качество платят скоростью: на CPU обработка одной страницы может занимать секунды, GPU — практически обязателен для потоковой обработки.
PaddleOCR (PP-OCR) — на мой взгляд, лучший баланс из открытых решений сейчас. Компактные модели детекции, классификации ориентации и распознавания в одном пайплайне, хорошая работа с кириллицей и смешанными текстами, приличная скорость. Когда задача — «оцифровать поток разнородных документов», я начинаю с него.
Surya — опенсорс-набор от VikParuchuri (github.com/datalab-to/surya), ориентированный на документы целиком: детекция строк, распознавание, определение порядка чтения и структуры. Полезен, когда важен не только текст, но и корректная последовательность блоков.
docTR — библиотека от Mindee (github.com/mindee/doctr) с продуманным API и двухступенчатой архитектурой «детекция + распознавание». Удобна как локальная основа, если не хочется тащить облако.
Модели понимания документов
Здесь важно разобраться с датировкой, потому что их часто подают как новинки — а это не так:
- LayoutLM — модель Microsoft 2019 года (с последующими версиями v2 и v3). Совместно учит текст и его координаты на странице, поэтому её используют для задач вроде «найди ИНН, дату и сумму в счёте» через извлечение сущностей, а не для сырого распознавания.
- TrOCR — также Microsoft, 2021 год. Энкодер-декодер на трансформерах, который переписывает картинку в строку текста. Критичная оговорка, которую упускают почти во всех обзорах: TrOCR работает с однострочными вырезками изображений. Скормить ему целую страницу нельзя — картинка сожмётся до квадрата, и результат будет мусором. Нужен отдельный детектор строк (из Surya, PaddleOCR или docTR), который нарежет страницу на строки, а TrOCR их прочитает.
- Donut — Naver/Clova, конец 2021. Идея интересная: end-to-end, изображение документа сразу конвертируется в JSON без отдельного этапа OCR. Для обученных типов документов (чеки, билеты) работает неплохо, но модель нужно дообучать на своих данных, а картинки должны быть похожи на обучающие.
Специализированные задачи
- Таблицы — Table Transformer (TATR) от Microsoft Research: детекция таблиц и распознавание их структуры (какие ячейки объединены, как уложены строки и колонки). Это то, чего нет ни в Tesseract, ни в TrOCR. Альтернатива без моделей — camelot и pdfplumber, но они работают только с текстовыми PDF, а не со сканами.
- Формулы — обычные движки формулы не читают. Практический стандарт де-факто — Mathpix: платный API, который возвращает LaTeX/MathML из формул. Для внутренней работы есть опенсорс-альтернативы вроде pix2tex, но по качеству Mathpix пока держит планку.
Облачные API
Google Vision, Azure AI Document Intelligence, Amazon Textract и — для российского контура — Yandex Vision. Свойства примерно одинаковые: лучшее качество из коробки, встроенная обработка таблиц и форм, поддержка русского. Минусы те же у всех: зависимость от сети, оплата за запрос (для больших потоков нужно считать экономику) и передача данных третьей стороне — для документов с персональными данными или коммерческой тайной это уже вопрос юристов, а не инженеров.
Мультимодальные LLM как OCR «по смыслу»
GPT-4o, Claude и Gemini умеют принимать изображения документов и возвращать сразу структурированный ответ: «вот шапка договора, вот таблица, вот подпись, вот сумма прописью». Это реально работающий подход для документов, где нужен не символьный пересказ, а интерпретация. Я описывал похожий подход в статье про автоматизацию документооборота в финтехе.
Но две границы у этого подхода жёсткие. Первая — LLM не идеальная вычислительная машина: на мелком тексте и плотных таблицах она может перепутать цифры или «сгенерировать» данные, которых на изображении не было. Галлюцинация чисел — это не гипотетика, это причина, по которой LLM нельзя ставить на распознавание реквизитов и сумм без валидации. Вторая — стоимость и задержка: страница через мультимодальную LLM обходится на порядки дороже, чем через PaddleOCR.
Практическая схема для надёжных систем: классический OCR извлекает текст, а LLM сверху структурирует и проверяет его. Так делается и в RAG-пайплайнах для корпоративных документов — модель получает уже распознанный текст, а не картинку.
Что работает хорошо
Печатный текст на качественном скане. Здесь выбор инструмента почти не важен: Tesseract 5.x, PaddleOCR, облачные API читают чистый шрифт без заметных ошибок. Экономика решает: локально и бесплатно или облако и удобно.
Сложная вёрстка — с оговоркой. Облачные API и Surya умеют определять порядок чтения в многоколоночных документах. Классические движки порядок чтения не понимают и собирают текст по координатам слева направо, сверху вниз — колонки перемешиваются. Если это ваша задача, либо современный инструмент, либо ручная сегментация страницы.
Многоязычные документы. PaddleOCR и облачные API корректно обрабатывают русско-английский микс. У Tesseract это тоже работает, если явно указать оба языка (tesseract image.png -l rus+eng), но качество на смеси заметно хуже нейросетевых решений.
Таблицы. Table Transformer и облачные API возвращают структуру, а не кашу из текста. Классические движки таблицу «прошьют насквозь» — все строки и ячейки сольются в сплошной поток токенов.
Где OCR по-прежнему спотыкается
Рукописный текст. Самая сложная задача из практических. Печатный разборчивый почерк (заполненные анкеты печатными буквами) облачные API и специализированные модели читают ощутимо хуже, чем печатный текст, но приемлемо. Живой рукописный почерк — лотерея: результат зависит от автора сильнее, чем от модели. Реалистичная архитектура здесь — распознавание плюс обязательная человеческая валидация критичных полей.
Фото с телефона. Перспективные искажения, неравномерное освещение, тени — всё это убивает качество до этапа распознавания. Хорошая предобработка (ниже код) часто даёт больший прирост, чем замена движка на более сильный.
Нестандартное оформление. Декоративные шрифты, текст на фоне изображений, водяные знаки, печати наложенные на текст — общая проблема всех инструментов. Печать пополам с подписью на документе — классический способ сломать распознавание ключевого блока.
Предобработка: половина результата до запуска OCR
Рабочий набор для «фото с телефона» и недоброкачественных сканов — OpenCV с проверенными этапами:
import cv2
import numpy as np

def preprocess_image(image):
    # Градации серого — цвет тексту не нужен
    gray = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

    # Медианный фильтр гасит точечный шум скана
    denoised = cv2.medianBlur(gray, 3)

    # Адаптивное выравнивание контраста по локальным окнам
    clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
    enhanced = clahe.apply(denoised)

    # Бинаризация по Оцу: автоматический порог чёрное/белое
    _, binary = cv2.threshold(
        enhanced, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU
    )

    return binary
К этому стоит добавить выравнивание наклона (deskew и методом перебора углов по разбросу строк, и по границам документа) и для снимков с телефона — коррекцию перспективы: найти контур листа, выпрямить в прямоугольник. Пайплайн несложный, но на пограничных сканах он решает исход задачи чаще, чем сам OCR-модель.
Прямые рекомендации по типовым задачам
Сканы документов РФ (паспорта, СНИЛС, счета, договоры). Если нет ограничений по утечке данных — Yandex Vision или Azure Document Intelligence: русские формы они понимают из коробки. Если данные нельзя передавать — PaddleOCR локально, плюс извлечение структурированных полей (ИНН, даты, КБК) регулярными выражениями сверху текста. Для договоров со штампами и печатями на тексте закладывайте разметку страниц и ручную сверку ключевых реквизитов.
Таблицы. Table Transformer локально либо облачные API с нативным распознаванием таблиц (Textract, Document Intelligence). Результат держите в машиночитаемом виде (CSV/HTML/JSON), а не в «тексте с пробелами». Для текстовых PDF-файлов сначала проверьте pdfplumber — возможно, OCR вообще не нужен.
Рукописное. Специализированные модели (TrOCR-handwritten, облачные API с handwritten-модом), качественная предобработка и обязательная человеческая валидация критичных полей. Полностью автоматическую систему на рукописном вводе я бы в продакшн без такого слоя не пускал.
Фото с телефона. OpenCV-предобработка (код выше + коррекция перспективы) → PaddleOCR или Surya. Эта связка закрывает большинство любительских снимков. Если документы критичные — мультимодальная LLM поверх как второй проход для сверки.
Структурированные данные из потока. OCR — только первый шаг. Затем валидация по словарям и регуляркам, сверка сумм, и только потом запись в систему. Это ровно тот подход, что работает и в парсинге данных — извлечение и валидация идут отдельными этапами.
Тренды на горизонте пары лет
По моим наблюдениям, движение идёт в трёх направлениях. Первое — конвергенция с LLM: всё чаще OCR не «цель, а вход» для модели, работающей с содержимым документа. Второе — перенос мощных моделей на устройства: Surya и PP-OCR уже работают на ноутбуке без GPU, качество растёт. Третье — автоматическое предраспознавание: инструменты, которые перед OCR сами улучшают изображение (сверхразрешение, устранение размытия).
И ещё один сдвиг на уровне архитектуры: документы перестают быть «текстом». Система спрашивает документ — OCR с LLM-интерпретацией отвечает. Так строятся AI-агенты для работы с документами, и качество распознавания в них — только один слой из нескольких.
FAQ
В: Стоит ли использовать Tesseract в 2026 году? О: Да — как первый кандидат для чистого печатного текста на приличных сканах: быстрый, бесплатный, локальный, отлаженный за десятилетия. Но это не универсальное решение: на рукописи, таблицах, сложной вёрстке и фото с телефона его качество заметно ниже нейросетевых альтернатив.
В: Какой облачный OCR выбрать для русского языка? О: Тестировать надо на своих документах — качество у лидеров близкое, и различия проявляются именно на специфике ваших форм. Практически: Yandex Vision для российского контура, Google Vision для многоязычных смешанных документов, Azure Document Intelligence для форм и таблиц, Textract для потока через AWS-инфраструктуру.
В: Можно ли обучить собственную OCR-модель? О: Можно, но реалистичный путь почти всегда — дообучение существующей модели на своих данных, а не обучение с нуля. С нуля нужны большой размеченный датасет и серьёзный вычислительный бюджет. При типичной задаче (специфический тип бланков) проще дообучить Donut или TrOCR на нескольких тысячах собственных сканов.
В: Как защититься от галлюцинаций цифр при OCR через LLM? О: Не распознавать цифры через LLM напрямую. Числовые поля извлекаете классическим OCR или детектором таблиц, а LLM используете для структурирования текста поверх уже распознанного с проверками: орфография, регулярки, арифметика, диапазоны значений.
В: Что даёт предобработка, если движок уже нейросетевой? О: Нейросетевой движок не волшебник — мусор на входе это мусор на выходе. Размытые и искажённые изображения после OpenCV-обработки показывают заметно лучший результат даже на сильных моделях. Вложить полчаса в предобработку часто дешевле, чем менять движок.
Нужна помощь с выбором или внедрением OCR-пайплайна под ваши документы? Напишите мне — обсудим, что даст результат на ваших данных.