 Артём Ротганк
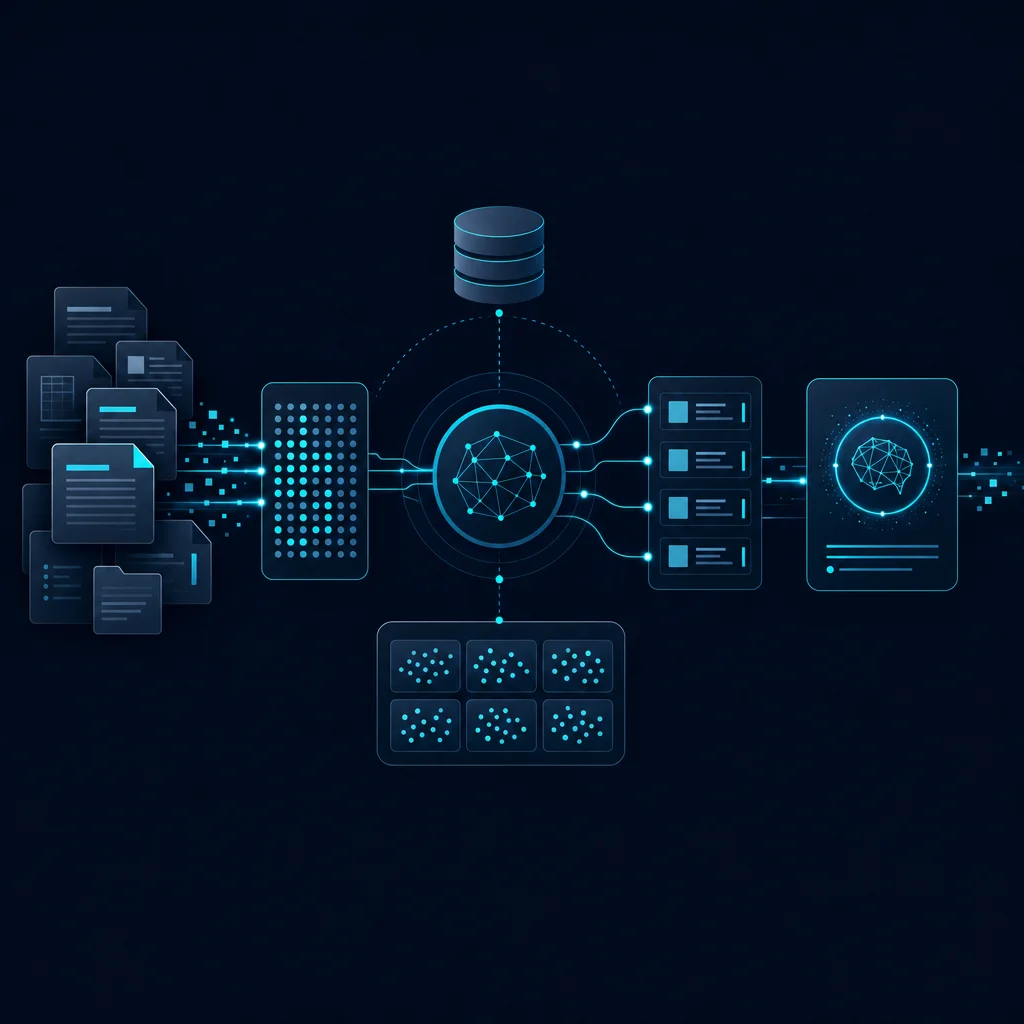
TL;DR: RAG (Retrieval Augmented Generation) — подход, при котором LLM перед генерацией ответа извлекает релевантные фрагменты из вашей базы документов и опирается на них. Это решает две главные проблемы LLM в корпоративном контуре: галлюцинации и устаревшие знания. Пайплайн состоит из ингеста, чанкинга, эмбеддингов, векторной БД, ретривера и LLM. Но работающий прототип и продакшн — разные вещи: в продакшне добавляются права доступа к документам, инкрементальная переиндексация, оценка качества и мониторинг. Обо всём этом — ниже, с рабочим кодом на pypdf, sentence-transformers и Qdrant.
Зачем вообще RAG для корпоративных документов
У LLM для корпоративного использования две системные проблемы:
- Галлюцинации. Модель выдаёт правдоподобно звучащий ответ, даже если не знает фактов. В бизнес-процессах — договоры, регламенты, расчёты — это недопустимо.
- Замороженные знания. Модель обучена на данных до определённой даты. Всё, что изменилось после — обновлённые регламенты, новые версии договоров, свежие тарифы — ей неизвестно. А корпоративные документы меняются постоянно.
RAG решает обе проблемы без переобучения модели: перед ответом мы извлекаем из базы знаний актуальные фрагменты и передаём их модели в контексте. Переобучение (fine-tuning) для этой задачи — неправильный инструмент вообще: оно меняет поведение модели, но плохо переносит фактическую информацию и не масштабируется на тысячи регулярно обновляемых документов.
Границы применимости RAG тоже важны. Если вам нужно агрегировать информацию по всему корпусу («просуммируй все договоры за год»), точечное извлечение чанков не справится — там нужны другие подходы, от map-reduce по документам до сценариев с постепенной компрессией контекста, похожих на то, о чём я писал в статье про память AI-систем.
Источники данных и ингест
Первый шаг — собрать документы и извлечь из них текст. Типовые источники:
- PDF (договоры, отчёты, методички)
- DOCX, XLSX, PPTX
- Страницы Confluence, SharePoint, корпоративной wiki
- Почта, тикеты, базы данных
Главная проблема на этом этапе — PDF. Корпоративные регламенты часто хранятся именно в нём, часто в виде сканов. Для текстовых PDF я использую pypdf:
from pypdf import PdfReader

def extract_text_from_pdf(path: str) -> str:
    reader = PdfReader(path)
    pages = []
    for page in reader.pages:
        text = page.extract_text()
        if text:
            pages.append(text)
    return "\n\n".join(pages)
Проверка if text важна: у страниц-сканов extract_text() вернёт None или пустую строку. Это сигнал, что документ требует OCR — про выбор OCR-инструментов и их реальное качество на сканах у меня есть отдельный разбор. Для сложной вёрстки (многоколоночные страницы, таблицы) pypdf даёт грязный текст — тогда смотрите в сторону Docling или PyMuPDF, и в любом случае пишите про это в лог: сколько страниц распарсилось, сколько пустых.
Типовая грабля ингеста: молчаливая деградация. Документ «загружен», но из него извлечено ноль символов, и в базе знаний его фактически нет. Всегда считайте и храните объём извлечённого текста на документ.
Чанкинг
LLM имеет ограниченное окно контекста, плюс длинные фрагменты ухудшают качество ретривала: эмбеддинг трёх страниц текста усредняет смысл до бесполезности. Поэтому текст разбивают на чанки.
Практические ориентиры, которые я использую как стартовую точку (это не законы, а эмпирически рабочие диапазоны, которые нужно проверять на ваших данных):
- Размер чанка: 200–1000 токенов. Для FAQ-образных вопросов ближе к 300–500, для плотных юридических текстов — 500–800.
- Перекрытие (overlap): 10–20% от размера чанка. Без перекрытия фразы, разорванные на границе чанков, теряются при ретривале.
- Границы: разбивать по абзацам и предложениям, а не по фиксированному числу символов.
Мой выбор — RecursiveCharacterTextSplitter из пакета langchain-text-splitters (большие сепараторы сначала: разделы, абзацы, затем предложения):
from langchain_text_splitters import RecursiveCharacterTextSplitter

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1500,       # символов; ~400-600 токенов для русского текста
    chunk_overlap=200,
    length_function=len,
    separators=["\n\n", "\n", ". ", " ", ""],
)

chunks = text_splitter.split_text(document_text)
Учтите: для кириллицы отношение «символов на токен» заметно ниже, чем для английского. 1500 символов русского текста — это ощутимо больше токенов, чем 1500 символов английского. Если оперируете токенами LLM напрямую, считайте их через tiktoken или токенизатор вашей модели, а не символы.
Обязательно сохраняйте метаданные с каждым чанком: идентификатор документа, версия, раздел, источник. Они понадобятся и для ссылок на источник в ответе, и для фильтрации по правам доступа — об этом в разделе про продакшн.
Эмбеддинги
Каждый чанк преобразуется в вектор — числовое представление смысла. Запрос пользователя тоже векторизуется, и поиск ближайших векторов даёт семантически похожие чанки.
Здесь важный момент для русскоязычных корпусов, на который часто наступают: популярные open-source модели all-MiniLM-L6-v2 и bge-large-en — англоязычные. На русском тексте они работают заметно хуже. Для многоязычных корпусов берите:
intfloat/multilingual-e5-large— сильная модель, но с обязательной оговоркой ниже;BAAI/bge-m3— многоязычная, поддерживает длинный контекст, умеет дополнительно sparse-представления для гибридного поиска.
Грабля с e5: модель обучена так, что требует префиксы query: для запросов и passage: для документов. Без префиксов качество ретривала заметно проседает — это зафиксировано в карточке модели и регулярно забывается в проде.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("intfloat/multilingual-e5-large")

def embed_chunks(chunk_texts: list[str]) -> list[list[float]]:
    prefixed = [f"passage: {t}" for t in chunk_texts]
    return model.encode(prefixed, normalize_embeddings=True).tolist()

def embed_query(query: str) -> list[float]:
    return model.encode(
        f"query: {query}", normalize_embeddings=True
    ).tolist()
Обратите внимание на normalize_embeddings=True — с нормализованными векторами скалярное произведение эквивалентно косинусной близости, и в настройках векторной БД можно выбирать более быстрый distance.
Если бюджет позволяет облачный API, альтернатива — OpenAI text-embedding-3-small или text-embedding-3-large. Модель text-embedding-ada-002 считается устаревшей: по качеству она уступает третьему поколению, новых причин её выбирать нет.
Векторная база данных и ретрив
Эмбеддинги с метаданными сохраняются в векторную БД — хранилище, оптимизированное для поиска ближайших соседей. Я сравнивал популярные варианты в статье про векторные базы. Для корпоративного RAG мой дефолт — Qdrant: есть фильтрация по полезной нагрузке (это критично для прав доступа), хороший self-hosted-режим, предсказуемое поведение.
Загрузка и поиск через qdrant-client:
from qdrant_client import QdrantClient
from qdrant_client.models import Distance, PointStruct, VectorParams

client = QdrantClient(url="http://qdrant:6333")
COLLECTION = "kb_e5_large"

def create_collection() -> None:
    client.create_collection(
        collection_name=COLLECTION,
        vectors_config=VectorParams(size=1024, distance=Distance.DOT),
    )

def upsert_chunks(chunks: list[dict]) -> None:
    points = [
        PointStruct(
            id=c["id"],
            vector=c["vector"],
            payload={
                "text": c["text"],
                "doc_id": c["doc_id"],
                "doc_version": c["doc_version"],
                "acl_groups": c["acl_groups"],
            },
        )
        for c in chunks
    ]
    client.upsert(collection_name=COLLECTION, points=points)

def retrieve(query: str, user_groups: list[str], k: int = 5):
    result = client.query_points(
        collection_name=COLLECTION,
        query=embed_query(query),
        query_filter={
            "must": [
                {"key": "acl_groups", "match": {"any": user_groups}}
            ]
        },
        limit=k,
        with_payload=True,
    )
    return result.points
Заметьте: актуальный метод — query_points, а не search (он объявлен устаревшим). В выдаче от query_points — объект, у которого точки лежат в поле .points, а не сам список напрямую.
На схеме весь пайплайн выглядит так:
+-------------------+   +----------------+   +----------------------+
| Корпоративные     |   | Ингест: pypdf, |   | Чанкинг + эмбеддинги |
| документы         |-->| OCR, DOCX      |-->| (e5 / bge-m3)        |
+-------------------+   +----------------+   +----------------------+
                                                  |
                                                  V
+-----------------------------------------------------------+
| Векторная БД (Qdrant): векторы + payload (doc_id, ACL)    |
+-----------------------------------------------------------+
                                                  ^
                  +--------------------+          | ретрив с фильтром по ACL
                  | Запрос пользователя|---> [векторизация запроса]
                  +--------------------+          |
                                                  V
+-----------------------------------------------------------+
| LLM: промпт + вопрос + найденные чанки -> ответ           |
+-----------------------------------------------------------+
Генерация ответа
Найденные чанки вместе с вопросом подаются в LLM. Системный промпт — три коротких обязательных правила:
Отвечай на вопрос, опираясь только на контекст ниже.
Если ответа в контексте нет — скажи об этом прямо, не додумывай.
В конце ответа укажи, из каких документов взята информация.

Контекст:
---
{chunks}
---
Вопрос: {question}
Требование ссылаться на источники — самое дешёвое средство от галлюцинаций на уровне продукта: пользователь видит, откуда ответ, и модель вынуждена «привязываться» к конкретным чанкам. Выбор LLM (GPT-4o/4.1, Claude, локальные модели) для этой задачи менее критичен, чем качество ретривала: хороший ретривер с mid-tire моделью даёт лучший результат, чем плохой ретривер с флагманом.
Оптимизация: что даёт эффект, а что — нет
Усложнять пайплайн стоит только после того, как есть метрики качества. Что реально даёт прирост, по моему опыту:
- Гибридный поиск. Векторный поиск + BM25 по ключевым словам. Нужен, когда в документах много артикулов, названий, аббревиатур — векторный поиск на точных токенах слаб. В Qdrant гибрид собирается через fusion query по dense и sparse векторам (bge-m3 удобна тем, что генерирует и то, и другое).
- Реранкер. Лёгкая cross-encoder модель (например,
BAAI/bge-reranker-v2-m3), которая пересортировывает топ-20 чанков и отбирает финальные 5. Один из самых дешёвых по трудозатратам способов поднять качество ответов. - Ограничение k. Искать 4–6 чанков. Больше — контекст размывается, растут стоимость и латентность, плюс проявляется эффект «lost in the middle»: модели хуже работают с информацией в середине длинного контекста.
А вот семантический чанкинг по NLP-моделям и мультимодальные эмбеддинги я бы откладывал последним приоритетом: сложность заметная, прирост — только на определённых типах документов.
Продакшн: то, чего нет в туториалах
Прототип на 50 документах работает за вечер. Проблемы начинаются, когда система выходит в реаль эксплуатацию. Ниже — пять вещей, которые почти никогда не описаны в гайдах, и которые вы обязаны решить до запуска.
Права доступа: permission-aware retrieval
Корпоративный RAG, который игнорирует права доступа, — это утечка данных как сервис. Сотрудник без доступа к HR-отчётам не должен получить их фрагменты в ответе чат-бота, даже если вопрос семантически совпадает.
Архитектурно есть два варианта:
- Фильтрация на ретриве (правильно). ACL-метки хранятся в метаданных чанка (
acl_groups,user_id,department), и запрос к векторной БД включает фильтр — как в примере выше сquery_filter. Векторный движок применяет фильтр во время поиска, поэтому запрещённые чанки не только не попадают в ответ, но и не влияют на ранжирование. - Постфильтрация (неправильно). Сначала найти чанки, потом выбросить запрещённые. Ломается дважды: может остаться меньше чанков, чем k, и существует риск утечки через промежуточные логи/кэш.
ACL-метки должны приезжать из источника (права папки в SharePoint, группы в AD/Keycloak) и проверяться при каждой переиндексации — права меняются чаще, чем контент.
Инкрементальная переиндексация
Реиндексировать всё при каждом изменении одного документа — дорого и бессмысленно. Схема, которая работает:
- Каждому чанку присваивается
doc_idиdoc_version(или хэш контента документа). - При изменении документа: удалить все чанки со старым
doc_id(в Qdrant —deleteс фильтром по payload), загрузить новые. - Неизменённые документы не трогаем — сравнение по хэшу делает ингест идемпотентным.
- Удалённый из источника документ = удаление чанков из коллекции. Регулярная сверка списка документов в источнике и в коллекции (reconciliation-джоба раз в сутки) ловит расхождения.
Смена модели эмбеддингов
Смена эмбеддеры — это полная переиндексация: векторы разных моделей несовместимы, смешивать их в одной коллекции нельзя категорически. Безболезненная схема:
- Создаётся новая коллекция (в примерах выше я недаром назвал коллекцию
kb_e5_large— имя модели в имени коллекции). - Параллельно идёт полная индексация в новую коллекцию; старая продолжает обслуживать запросы.
- Качество новой модели проверяется на вашем оценочном наборе (см. ниже).
- Переключение — одна операция: приложение начинает читать из новой коллекции. Старая удаляется после периода наблюдения.
Сине-зелёная индексация стоит минимум кода и убирает весь класс проблем «переезда».
Оценка качества
Локальное «потыкал — вроде отвечает» в проде не работает. Нужен воспроизводимый оценочный набор: 50–200 пар «вопрос — эталонный ответ — документ-источник», собранных из реальных вопросов пользователей. Дальше два пути, оба приемлемы:
- Ragas — фреймворк с готовыми метриками: faithfulness (ответ опирается на контекст), context precision/recall (качество ретривала), answer relevancy. Быстрый старт, но имейте в виду: метрики считает LLM, то есть есть погрешность самой оценки.
- Собственный скрипт по вашему набору: для каждого вопроса проверяется, попал ли документ-источник в топ-k (retrieval hit rate), и соответствует ли ответ эталону (через LLM-асессора или ручную разметку выборки).
Минимум, который я считаю обязательным перед сменой эмбедера, модели LLM или стратегии чанкинга: retrieval hit rate на вашем наборе. Именно она показывает, поломает ли изменение поиск, а не просто текст ответов.
Мониторинг
Что логировать и смотреть на дашборде:
- Пустой ретрив. Доля запросов с нулём или очень низкими скорами у топ-чанка. Рост — сигнал, что пользователи спрашивают о том, чего нет в базе: либо незагруженные документы, либо молчаливая деградация ингеста.
- Латентность по этапам: векторизация, поиск, генерация. Типичный виновник медленного RAG — не векторная БД, а LLM.
- Обратная связь. Минимум — кнопки «ответ помог / не помог» с сохранением запроса. Негативные оценки — источник для пополнения оценочного набора.
- Свежесть индекса: время последней успешной синхронизации по каждому источнику.
Если делаете сервисную обвязку сами, обычно это FastAPI плюс простой очереди-воркер для ингеста; про выбор фреймворка есть моя статья про FastAPI для AI-продуктов.
FAQ
Q1: Какую векторную базу данных выбрать?
Для корпоративного RAG — Qdrant, если планируете self-hosted и нужна фильтрация по метаданным (а для ACL она обязательна). Pinecone — если хотите managed-сервис и не тащить инфраструктуру. Chroma подходит для прототипа, но для продакшена с большим корпусом и требованиями к ACL я бы на неё не закладывался. Подробное сравнение — в моём разборе векторных БД.
Q2: Какие модели эмбеддингов использовать для русскоязычных документов?
Открытые: intfloat/multilingual-e5-large или BAAI/bge-m3 — обе многоязычные. Не берите англоязычные all-MiniLM-L6-v2 и bge-large-en: на русском они теряют качество. У e5 не забывайте префиксы query: и passage:. Если допустим облачный API — OpenAI text-embedding-3-small как базовый вариант, text-embedding-3-large для максимального качества. В любом случае сравнивайте кандидатов на своём оценочном наборе, а не на публичных бенчмарках.
Q3: Сколько чанков подавать в LLM?
4–6 релевантных чанков. Меньше — неполные ответы, больше — размывание контекста, рост стоимости и эффект «потери в середине». Если точности не хватает, сначала пробуйте реранкер, а не увеличение k.
Q4: Можно ли использовать RAG без векторной базы данных?
Можно извлекать документы полнотекстовым поиском (Elasticsearch/OpenSearch), и это разумно, когда у вас уже есть работающий кластер и корпус с точными терминами. Но векторный поиск лучше ловит смысловые совпадения — пользователь редко формулирует вопрос словами вашего регламента. Оптимум для большинства — гибрид: векторы + BM25.
Q5: Насколько сложно поддерживать RAG-пайплайн?
Поддержка — это не кнопка «забыть», а регулярные процессы: инкрементальная синхронизация документов, сверка индекса с источниками, пополнение оценочного набора на реальных вопросах, прогон оценок при любой смене моделей. По трудозатратам это намного легче переобучения LLM, но это всё равно полноценная эксплуатация сервиса — выделяйте на неё время команды с самого старта.
Q6: Когда RAG не подойдёт?
Когда задача требует обработки всего корпуса целиком (агрегация по всем договорам, аналитика по всем отчётам), а не точечного нахождения фактов. Точечные вопросы «каков срок уведомления по статье 7.3» — идеальная зона RAG; «сравни условия во всех договорах аренды» — уже нет.
Нужен RAG, который пройдёт аудит безопасности и не рассыплется в проде? Напишите мне — обсудим вашу задачу.